Gemini Omni Flash 1.1 详解:10秒场景延展、4K超分与多语言支持
深入解析 Gemini Omni Flash 1.1:掌握10秒场景延展、4K分辨率上采样及多语言处理能力,了解如何将其集成到您的工作流中。
Veo3 AI · 3 min read · Sep 28, 2026
你可能手头有一段视频,完成度已达 80%,却因一次糟糕的剪辑而功亏一篑:光线突然偏移、人物面部轻微漂移、镜头间背景细节消失……刹那间,整段剪辑便不再像同一场景。Gemini Omni Flash 1.1 的独特之处在于,它直击这一真实制作痛点——不靠电影级的玄妙渲染,而是凭借更强的画面连贯性、更快的迭代速度,以及更贴近真实剪辑逻辑的工作流。
如果你正在横向对比各类 AI 视频工具,真正关键的问题并非“某个模型能否一次性生成炫酷效果”,而在于:它能否在足够长的时间内稳定保持角色形象、运镜方式与视觉风格的一致性,直至你最终交付成片。
目录
<a id="the-shift-to-production-ready-video-generation"></a>
迈向可投入生产的视频生成
一个“可投入生产”的视频模型之所以重要,是因为团队需要一套可重复执行、可审阅反馈、可持续优化的工作流程,而非每次都要从零开始。谷歌于 2026 年 8 月 27 日正式发布 Gemini Omni 1.1 Flash,作为通用可用(General Availability)模型,并通过 Google AI Studio、Gemini Enterprise Agent Platform、Google Flow,以及面向全球 Google AI Plus、Pro 和 Ultra 订阅用户的渠道开放使用[谷歌官方发布博文]。
此次发布标志着该模型正式脱离预览阶段,进入可被团队纳入长期规划的稳定工作流。谷歌将其定义为一套快速、支持对话式交互的视频生成与编辑系统——其核心价值不在于单次产出惊艳片段,而在于能否在审阅意见、反复修改与审批流程中始终保持可用性与一致性。
实用准则: 将该模型视作一位编辑助理,而非魔法棒。短周期、受控式的多次迭代,通常比试图用单条提示词一步到位获得更干净、更可靠的结果。
谷歌的发布资料还将场景延展、起始帧与结束帧指定以及4K 输出列为关键控制功能。这套工具为视频制作人提供了切实可用的工作抓手:先构建粗剪版本,稳定视觉构思,再精细化调整每一帧细节,最终交付成片。相较于仅能生成一次惊艳但后续调整空间极小的视频生成器,该方案更契合社交媒体素材、产品说明视频及广告变体等实际应用场景。
实际工作流程十分清晰:先以较低分辨率完成初稿,检查镜头间的连贯性,修正薄弱的转场或动作节奏点,待剪辑整体稳固后,再输出最终版本。对于正在测试 gemini omni flash 1.1 的团队而言,这标志着一次真正意义上的转变——一款顺应而非对抗专业制作习惯的模型。
<a id="technical-leaps-in-scene-extension-and-resolution"></a>
场景延展与分辨率方面的技术跃升
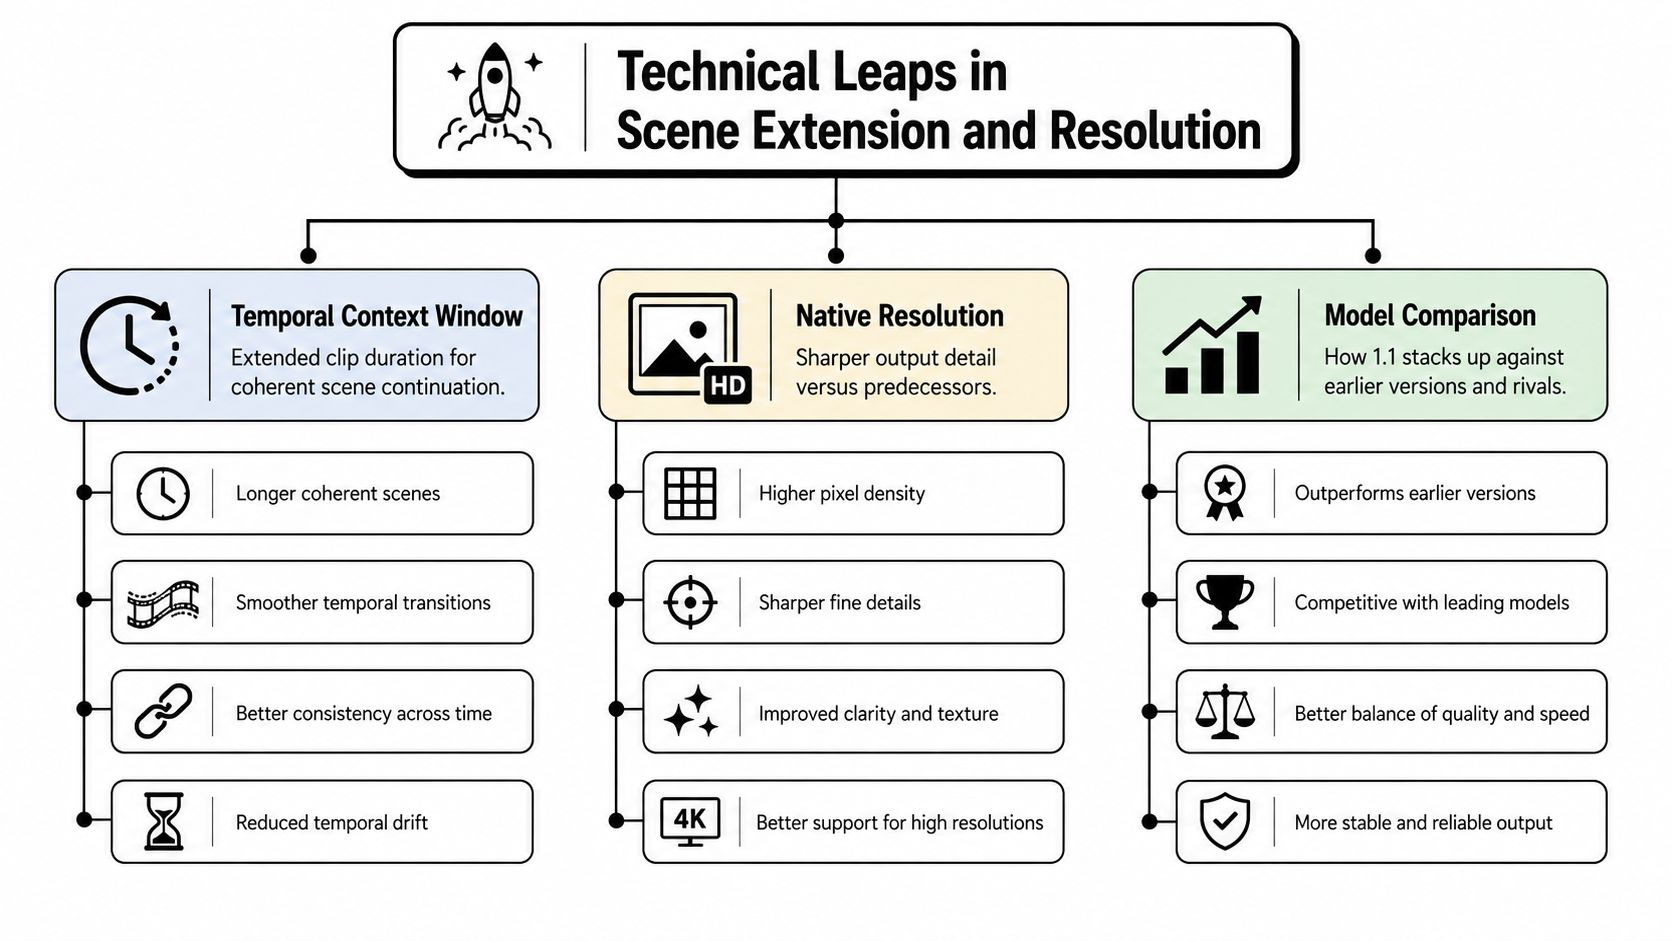
最主要的技术突破在于场景延展所支持的10 秒上下文窗口。谷歌表示,该模型可基于源视频片段的10 秒上下文进行延展,相较 Veo 仅支持1 秒上下文有了显著提升(参见 Google AI on X)。从剪辑角度看,这段额外的“记忆”至关重要——它使模型足以延续一个动作、一种姿态或一个切出镜头,而不会丢失叙事线索。
<a id="why-the-extra-context-matters"></a>
额外上下文为何重要
更长的时间窗口有助于在镜头切换之间维持人物身份一致性、光照连续性以及叙事状态稳定性。例如,当主体在讲话中途转身,或外套在变化的光照下产生明暗偏移时,模型可依托更丰富的前期画面信息,在延展场景时准确保留这些细节。早期系统往往在此类过渡镜头中失效,尤其当剪辑需呈现自然连贯感而非突兀重置时。
谷歌官方文档指出,Omni Flash 支持视频延展、分辨率超分与高级插帧,专为快速、对话式视频生成与编辑而构建(参见 Gemini API 文档)。其发布资料还进一步说明:原生支持生成3 至 10 秒的短视频片段、内置音频、延展最长可达40 秒,输出分辨率选项涵盖360p、720p、1080p 及 4K。这些参数共同界定了制作人在实际工作中可操作的有效范围。
<a id="what-the-quality-ladder-changes"></a>
质量阶梯的演进意义
质量阶梯之所以重要,在于它明确区分了创意探索阶段与交付阶段。该模型文档还列出了最长 10 秒的视频输入用于编辑与延展,并配备1,048,576 Token 的上下文窗口(参见 Gemini Omni Flash 模型文档)。实践中,这意味着文本、图像与视频输入可共同参与同一镜头决策过程,而非被当作彼此割裂的独立资产分别处理。
我采用这种工作流程:先快速起草,待场景运动表现正确后再精细调整动作。如有需要,可先从较低分辨率开始。首要任务是锁定画面连续性,重点检查运动的起始与结束帧;仅当剪辑整体稳定后,再提升画质。这正是 gemini omni flash 1.1 的实用价值所在——它契合一种既重视速度、也强调一致性的生产闭环。
制片人备注:连续性问题通常出现在镜头衔接处,而非干净单镜的中间段落。请优先测试转场效果,再检查纹理与细节表现。
<a id="accessing-the-model-and-integration-requirements"></a>
模型访问方式与集成要求
访问方式取决于您计划如何使用该模型。开发者可通过 Gemini API 和 Google AI Studio 进行开发;企业团队则可借助 Gemini Enterprise Agent Platform Google 发布公告。此外,Google 还为 Plus、Pro 和 Ultra 订阅用户,在 Flow 及 Gemini 应用内提供订阅制访问权限,其中场景延展(scene extension)功能已面向全球开放。
<a id="integration-pathways-and-requirements"></a>
集成路径与要求
| 访问方式 | 上下文 / 输入限制 | 最适用场景 |
|---|---|---|
| Google AI Studio 中的 Gemini API | 1,048,576 token 模型上下文长度,视频输入最长支持 10 秒(适用于编辑与延展) | 自定义应用、内部工具、生产管线 |
| Gemini Enterprise Agent Platform | 通过企业级工作流调用同一系列模型 | 团队部署、受控的企业级业务应用 |
| Google Flow 与 Gemini 应用订阅访问 | Plus、Pro 和 Ultra 用户可在全球范围内使用场景延展功能 | 希望直接使用原生应用功能、无需 API 开发的创作者 |
最简明的配置原则是:严格约束输入内容。该模型支持 文本、图像与视频 输入,因此提示词应仅包含当前镜头真正需要的细节信息 Gemini Omni Flash 模型文档。实践中,精简的输入集更利于在多次延展过程中保持镜头意图的一致性——尤其当剪辑连续性比探索所有可能变体更为关键时。
对于既关注内容发现(discovery)又重视输出质量的团队,AI 内容发现策略指南 是一份有益的延伸阅读。尽管其聚焦于可见性规划而非视频制作设置,但其中强调的纪律性同样适用于如下场景:一段由模型生成的视频片段需同时支撑搜索曝光、社交媒体传播及产品信息传达。
<a id="what-to-configure-before-you-start"></a>
启动前需配置事项
实际的前期配置工作,核心在于避免资源浪费。请将参考镜头控制在较短时长,清晰标注预期运动特征,并使输出规划与当前渲染阶段相匹配。低分辨率草稿适用于快速迭代,而最终交付则应在镜头确认无误后,以更高分辨率完成。
我将 API 路径视作一个受控的动作实验室。它在团队已明确镜头需承载何种表达时效果最佳,且在既追求速度、又高度重视连续性的生产闭环中表现最强。
<a id="navigating-multilingual-prompts-and-typography-limits"></a>
多语言提示词与字体排印限制应对方案
多语言提示词能让模型在视觉上显得流利自如,直到画面中需要呈现可读文字时——这正是其薄弱环节暴露之处。在我的测试中,图像质量与动态表现通常保持良好,但字幕、标牌、产品标签及混合语言排版却极易迅速失真。对日语和韩语创作者而言,这一差异直接决定了视频片段能否在首次生成后即投入使用,还是必须在后期制作中进行全面修复。
<a id="where-the-model-is-strong-and-where-it-isnt"></a>
模型的优势所在与短板所在
使用日语或韩语撰写提示词仍可有效引导场景意图,但画面上的文字渲染可靠性远低于整体视觉构成。模型通常更擅长处理运镜、构图与整体氛围,而对细微的排版细节(如字符间距、字形适配)则表现欠佳。它更适合生成剪辑中的人物对话(后续可配音或加字幕),而非精准呈现 Logo 组合、字幕条,或任何依赖精确字符定位的版式设计。
实用的应对策略是任务拆分:先用模型生成镜头、运动与视觉基调,再于后期制作中添加本地化文字。若文字本身是画面动作的一部分,则应在生成阶段尽量简化,并预留后期替换空间。对于需全程保障文字可读性、又不愿逐帧与模型“搏斗”的团队,AI 视频中的文字渲染提示词指南 是一份有价值的参考资料。
经验法则:若文字必须被准确无误地阅读,请勿要求模型直接完美渲染它。
<a id="prompting-strategy-that-saves-time"></a>
节省时间的提示词策略
即使最终受众并非英语使用者,英文提示词往往能带来更可预测的运镜控制效果。这并不意味着成片必须保留英文内容;而是指模型在理解英文动作指令时更为精准,而可见文字则可留待后期制作阶段统一处理。由此形成一种高效分工:场景控制交由模型完成,最终文字交付则由后期负责。
对日语和韩语团队而言,最可靠的流程是:先生成纯视觉内容,将内嵌文字压缩至最低限度,并将字幕、产品标题与标牌等全部视为后期收尾工作。此举既聚焦核心场景表达,也避免将渲染资源浪费在模型本就容易出错的排版环节。
<a id="real-world-applications-for-short-form-and-ad-creatives"></a>
短视频与广告创意的实际应用场景
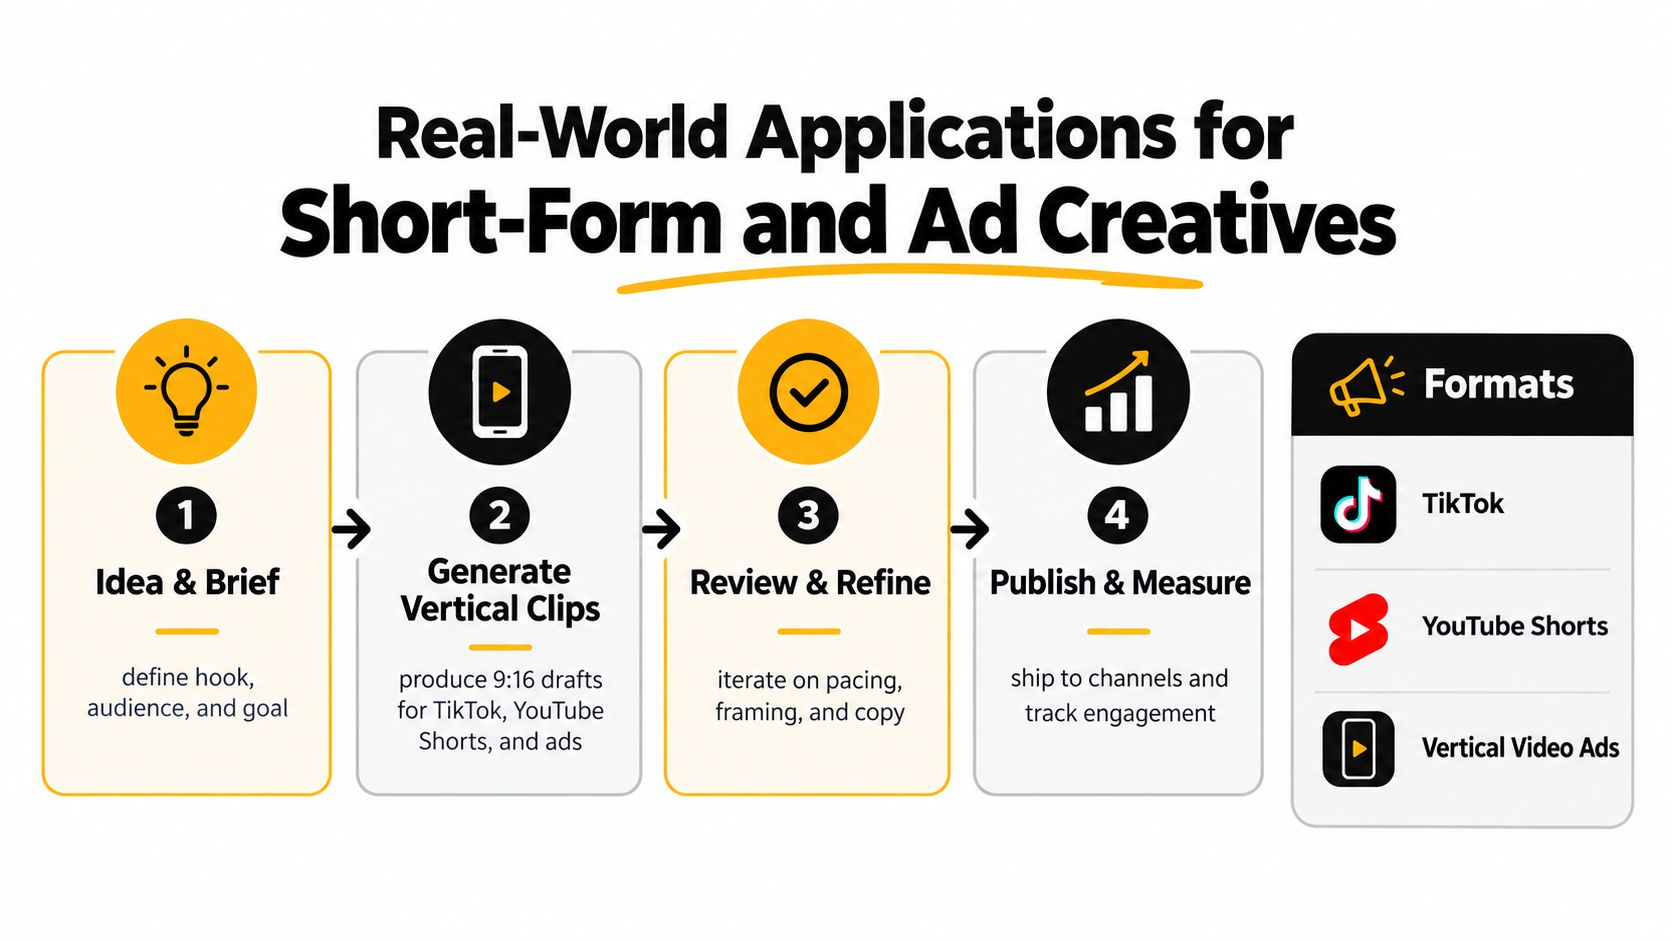
当项目需求明确、剪辑方案清晰时,该模型在短视频制作中能释放最大价值。建议从强吸引力的开场钩子(hook)入手,构建竖屏初稿,并在不同变体中持续延展同一视觉概念。关于此类创意结构的外部参考,可参阅 短视频的钩子设计与工作流指南,尤其适用于需将单一创意转化为多个平台原生版本的场景。
<a id="a-practical-campaign-flow"></a>
一套实用的广告活动工作流
从一份涵盖三个问题的单次营销简报开始:钩子是什么?面向谁?后续应采取什么行动?然后为 TikTok、YouTube Shorts 和竖版视频广告生成 9:16 格式的初稿——因为快节奏创意通常需在这些渠道快速见效。
效果最佳的做法:一次只聚焦一个创意点、一种运镜模式、一个变量。若所有元素同时变动,便无法明确判断究竟是哪项优化提升了成片效果。
当转场需呈现刻意设计感(而非偶然感)时,请使用首帧与末帧控制。该技术有助于产品露出、跨房间移动、以及需要体现“计划性剪辑”质感的镜头推进。谷歌的发布帖也指出,可借助视频参考素材来保持视觉上下文与角色一致性——这对需在多条成片中维持同一张面孔、同一套穿搭或统一情绪基调的营销活动尤为实用。
对广告团队而言,核心收益在于测试方案的设计。针对同一份简报,构建两到三个钩子变体,在概念全面铺开前先行比对;同时保持剪辑语言一致,确保测试结果清晰可读。早期验证阶段,360p 分辨率的初稿已足够;而仅当成片将用于付费投放、客户审阅,或已获批准并进入终版精修环节时,才需以 4K 重新渲染。
<a id="where-the-model-pays-off"></a>
模型真正发挥价值的场景
最强优势在于小幅度编辑间的画面连贯性,而非单次输出一个宏大叙事。长达 40 秒 的延展式输出可用于短广告故事叙述(前提是各段落衔接自然),但其核心价值仍体现在模型能否精准维系镜头与镜头之间的叙事线索。
<iframe width="100%" style="aspect-ratio: 16 / 9;" src="https://www.youtube.com/embed/rbF4rEEApfM" frameborder="0" allow="autoplay; encrypted-media" allowfullscreen></iframe>
进行社媒测试时,切勿直接从最复杂的场景入手。先构建一个干净利落的转场,确认画面稳定性,再以此为基础批量生成变体。初期节奏虽稍慢,却能避免将渲染资源浪费在本就缺乏潜力的钩子上。
<a id="choosing-the-right-tool-for-your-video-workflow"></a>
为您的视频工作流选择合适工具
正确选择取决于您对整个流程的掌控需求。若您需要 API 级别控制、模型专属路由及自定义剪辑逻辑,Gemini Omni Flash 1.1 是一项严肃选择;若您更倾向在统一界面内操作,且该平台已原生集成 Veo 3.1、Seedance 与 Hailuo,那么类似 Veo 3 AI 视频生成器 的一体化平台,可通过减少工具切换,显著简化工作流。
这一权衡至关重要:部分团队希望主导每一步执行,而另一些团队则追求从提示词直达导出的高效路径。当目标是快速渲染、内置定制能力,以及为不同代际视频模型提供简洁直观的操作界面时,专用平台更具吸引力。谷歌的方案则更为模块化——这在需要高精度控制时极具优势,但也意味着您需自行承担更多流程设计责任。
如需更全面地对比各类工具与创作者工作流,面向创作者的 AI 视频工具指南 提供了有益背景参考。它有助于厘清“原始能力”与“使用便捷性”之间的取舍——而这往往才是模型选型背后的真实决策逻辑。
<a id="how-to-decide"></a>
如何决策
如果你的工作依赖于画面连贯性、帧率控制以及自定义集成,那么 Google 的技术栈是合理的选择。但若你的首要目标是从创意构想到最终输出的速度,且希望减少组件数量、使用统一平台,则后者通常更易上手、更易长期维护。两种路径并无绝对优劣之分,而是分别解决不同类型的制作问题。
对我而言,本次发布中最明确的信号是:gemini omni flash 1.1 显然是为真实迭代而生,而非仅为展示短片打造。它足够快,可支撑快速草稿创作;足够严谨,能胜任对连贯性要求严苛的剪辑任务;也足够坦诚——直面其弱项(多语言排版),让团队得以提前规划应对策略,而非在项目后期才猝不及防地暴露问题。
如果你希望以更简单的方式测试 AI 视频工作流,无需手动拼接多个独立工具,Veo3 AI 提供了一个统一平台,支持基于文本提示和基于图像的视频生成。这是对比不同创意方案的实用下一步,尤其适合你在正式选定生产管线前,评估自己究竟需要多大程度的控制力。
Related Articles
Continue with more blog posts in the same locale.
Google Flow 免费吗?定价、积分与使用限制(2026)
Google Flow 免费吗?讲清每日 50 积分、Google AI 订阅价格、每条 Veo 3.1 视频的积分消耗、高峰时段限制,以及免费额度实际能做多少。
Read article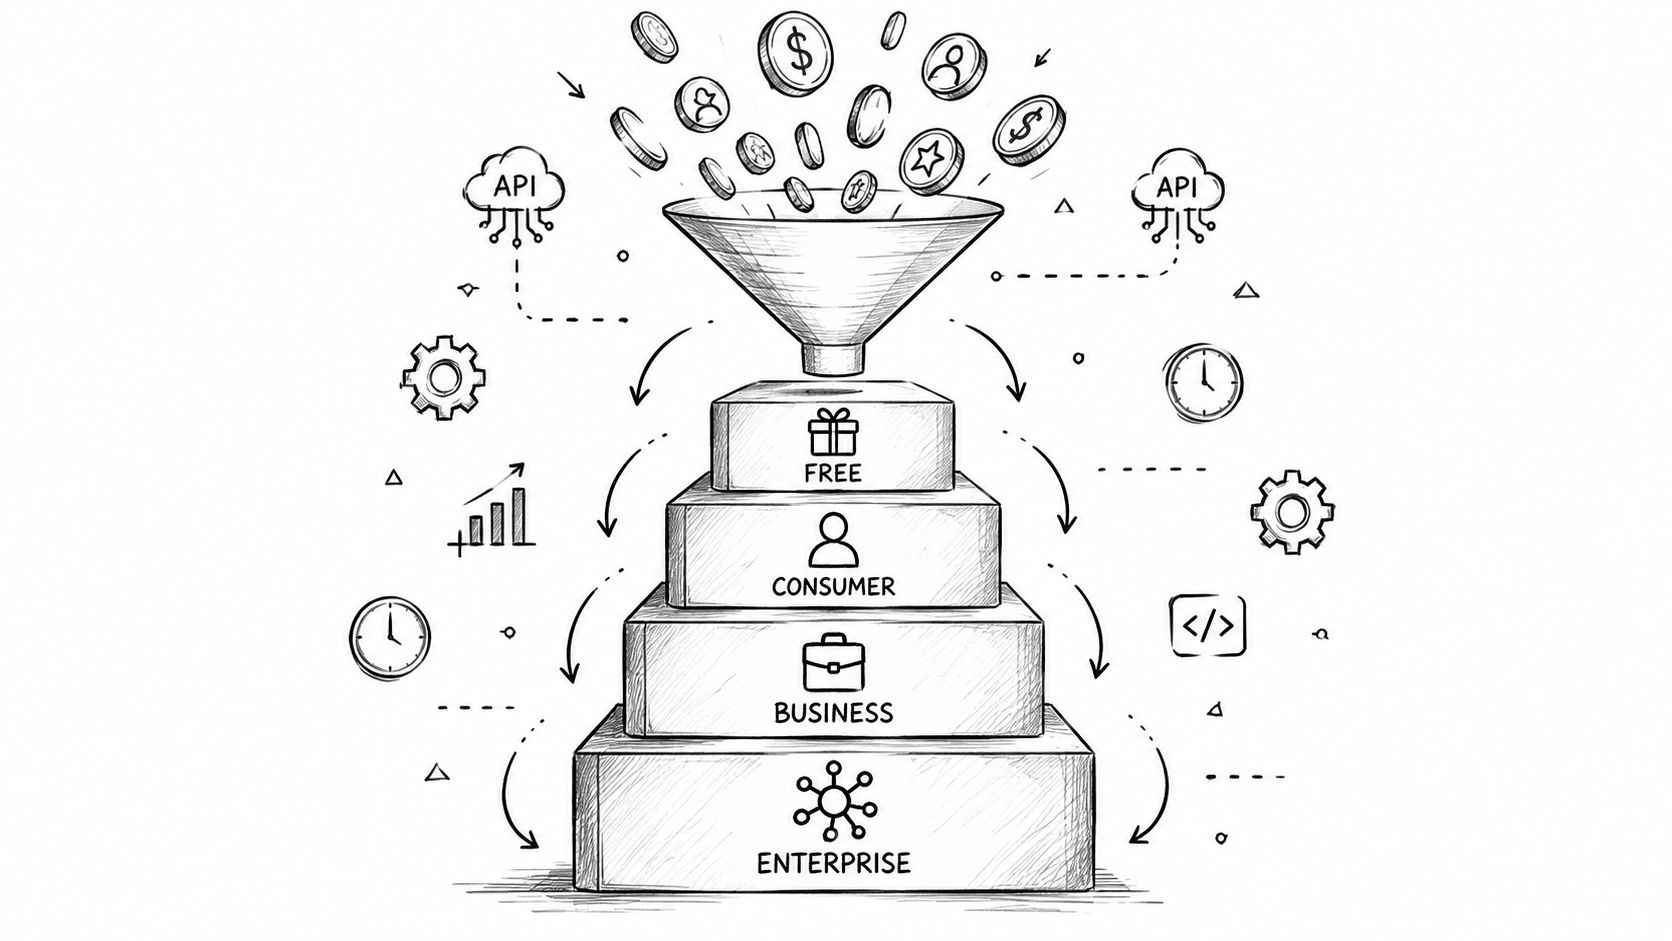
Gemini Omni 费用详解:创作者的定价层级
Gemini Omni 费用拆解:面向消费者与 API 的定价、Token 计费模型、分辨率相关成本,以及短视频创作者可享的免费使用选项。
Read article
Gemini Omni 免费版:2026 年可用的免费访问途径
汇总 2026 年所有可用的 Gemini Omni 免费访问途径,涵盖 YouTube Shorts Remix、免费试用层等,附详细设置方法与使用限制说明。
Read article